

QueryLiftでは、生成AIの回答における自社・競合の言及や、Webページの引用状況などの様々なGEOデータを抽出してDBに保存しています。その上で良質なGEO体験をユーザーに届けるためには、APIレスポンスを高速化させることに加え、表示される数値の意味的な正しさが重要と考えております。
競合やブランド名の表記揺れの設定を変更した際には、保存済みの回答から過去の指標を再計算する必要があります。保存済みの回答から新しい条件で指標を再計算することや、機能の改善によって集計結果が意図せず変わっていないかを検証することも、分析基盤の設計に含まれます。
本記事では、QueryLiftの分析基盤におけるデータ設計の取り組みについて紹介します。
1. 分析APIのレスポンスを高速化するMV設計
分析APIの集計要件に合わせてMVを設計する
分析画面では、言及率や引用率、時系列の推移など、複数の指標を扱います。リクエストのたびに保存済みの回答を読み込み、本文中のブランド名を照合したり、引用先を分類したりすると、データの蓄積に伴ってAPIリクエスト時の処理が重くなります。
そこでQueryLiftでは、PostgreSQLのマテリアライズドビュー(以下、MV)を利用しています。通常のテーブルにはアプリケーションがデータを書き込みます。一方、MVは、あらかじめ定義したSQLの実行結果を保存し、リフレッシュによって更新する仕組みです。分析APIは保存済みの結果を参照できるため、リクエストのたびに同じ集計を繰り返す必要がありません。
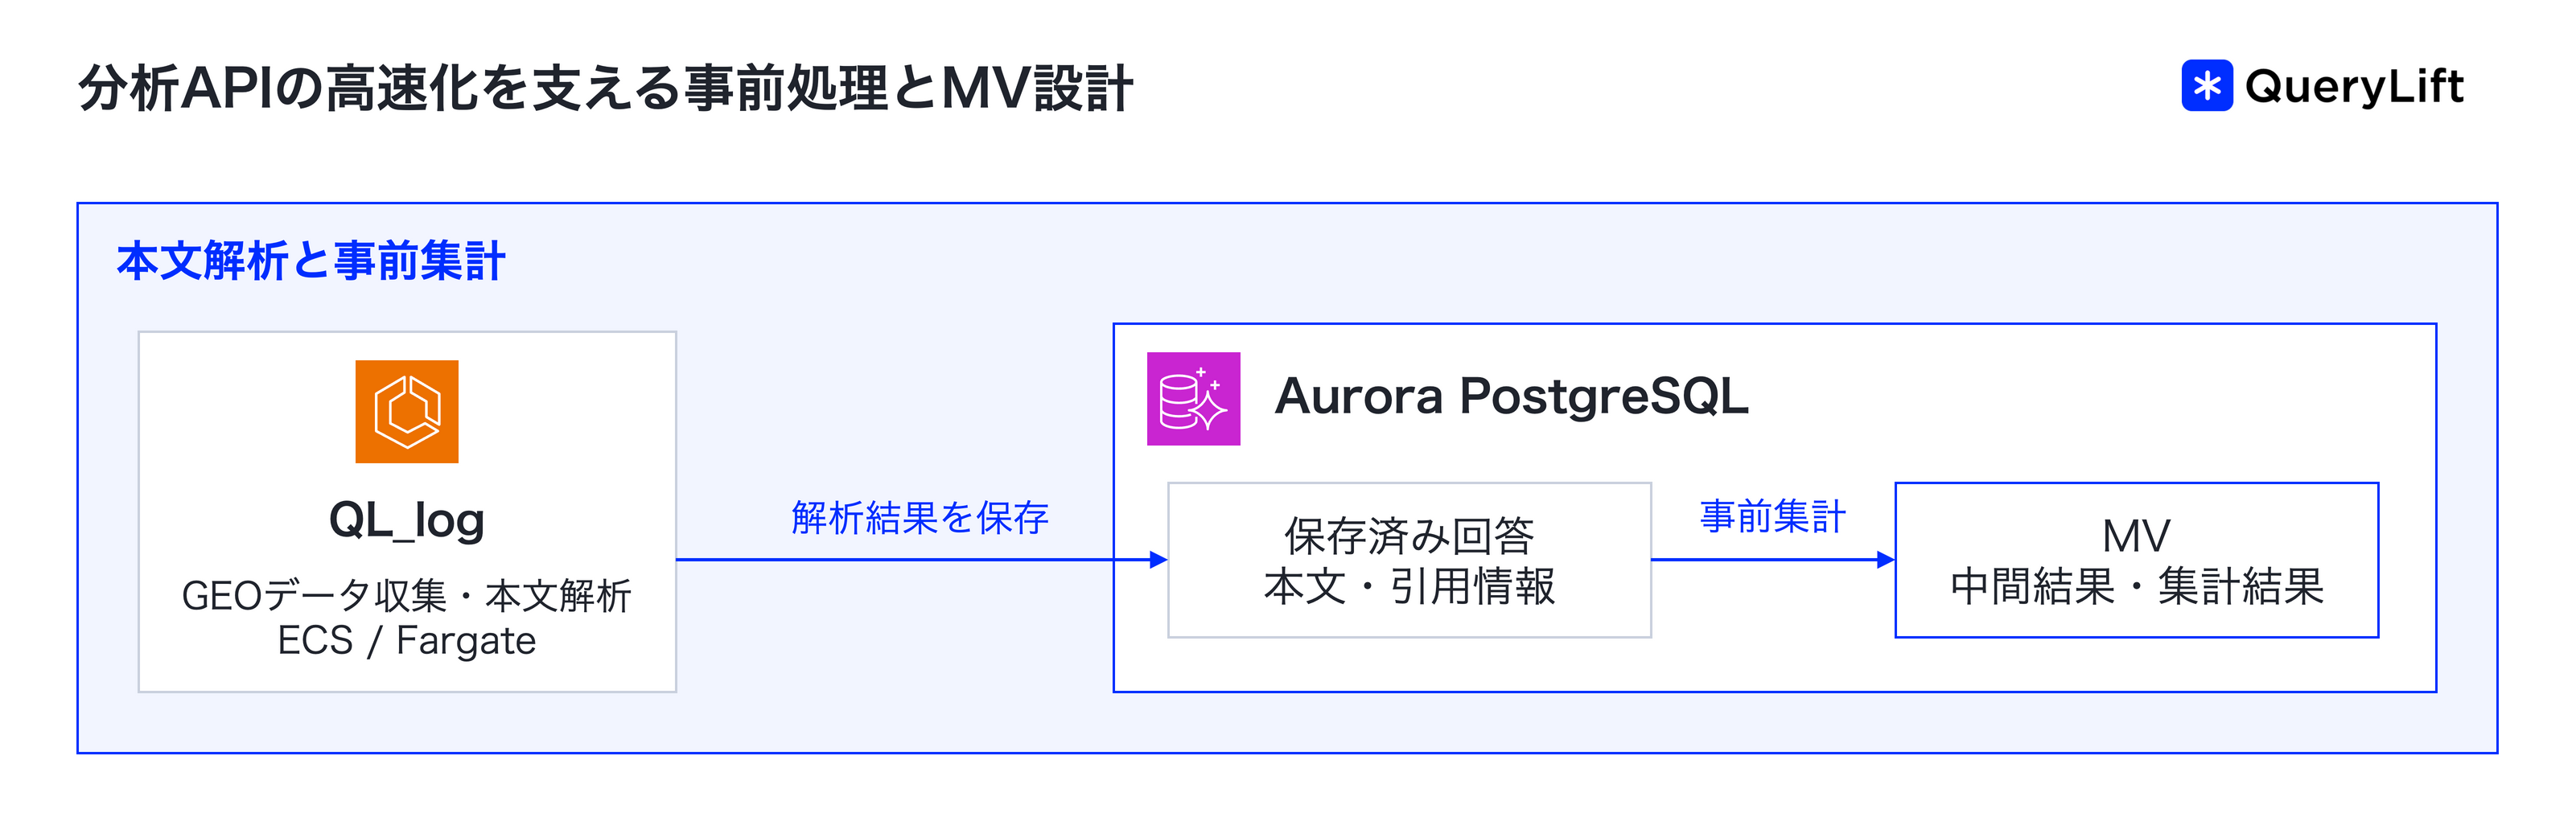
本文解析はワーカーで実行し、MVで集計する
とはいえ、全てのデータをMVとして集めればよいというわけでもありません。例えば、回答本文からブランドの言及順位を求める処理は、LLMの回答文章を探索して順位を集計する必要があるので、更新のたびに大量の本文を解析することになり、MV更新自体の負荷が大きくなります。
そこで言及順位では、本文の解析をワーカーで実行し、結果をMVではない通常のテーブルに保存する構成にしています。処理対象を日付や回答IDの範囲で分け、MVは保存済みの結果を集計します。画面への応答だけでなく、事前計算を継続して更新するコストも考え、MVとして保存するものとそうでないもので処理を分担しています。
2. データ収集からAPIレスポンスまでのシステムフロー
収集完了イベントを起点にMVを依存順に更新する
MVは保存済みの計算結果を読む仕組みなので、元データが増えただけでは分析結果に反映されません。どのタイミングで、どの順序で更新するかを管理する必要があります。
QueryLiftでは、日次実行されるGEOデータ収集バッチが終了条件を満たした後にイベントを発行し、EventBridgeとStep Functionsを通じてMVの更新処理へ進みます。MV同士にも依存関係があるため、基礎となるMVから後続のMVへ、段階を分けて更新します。同じ段階の処理は並列度を制限し、前の段階が成功してから次へ進む構成です。
APIリクエストは日次バッチとは独立して受け付けます。ブラウザからフロントエンドを経由して分析APIを呼び出し、APIがMVをSQLで参照して返した結果を画面に表示します。
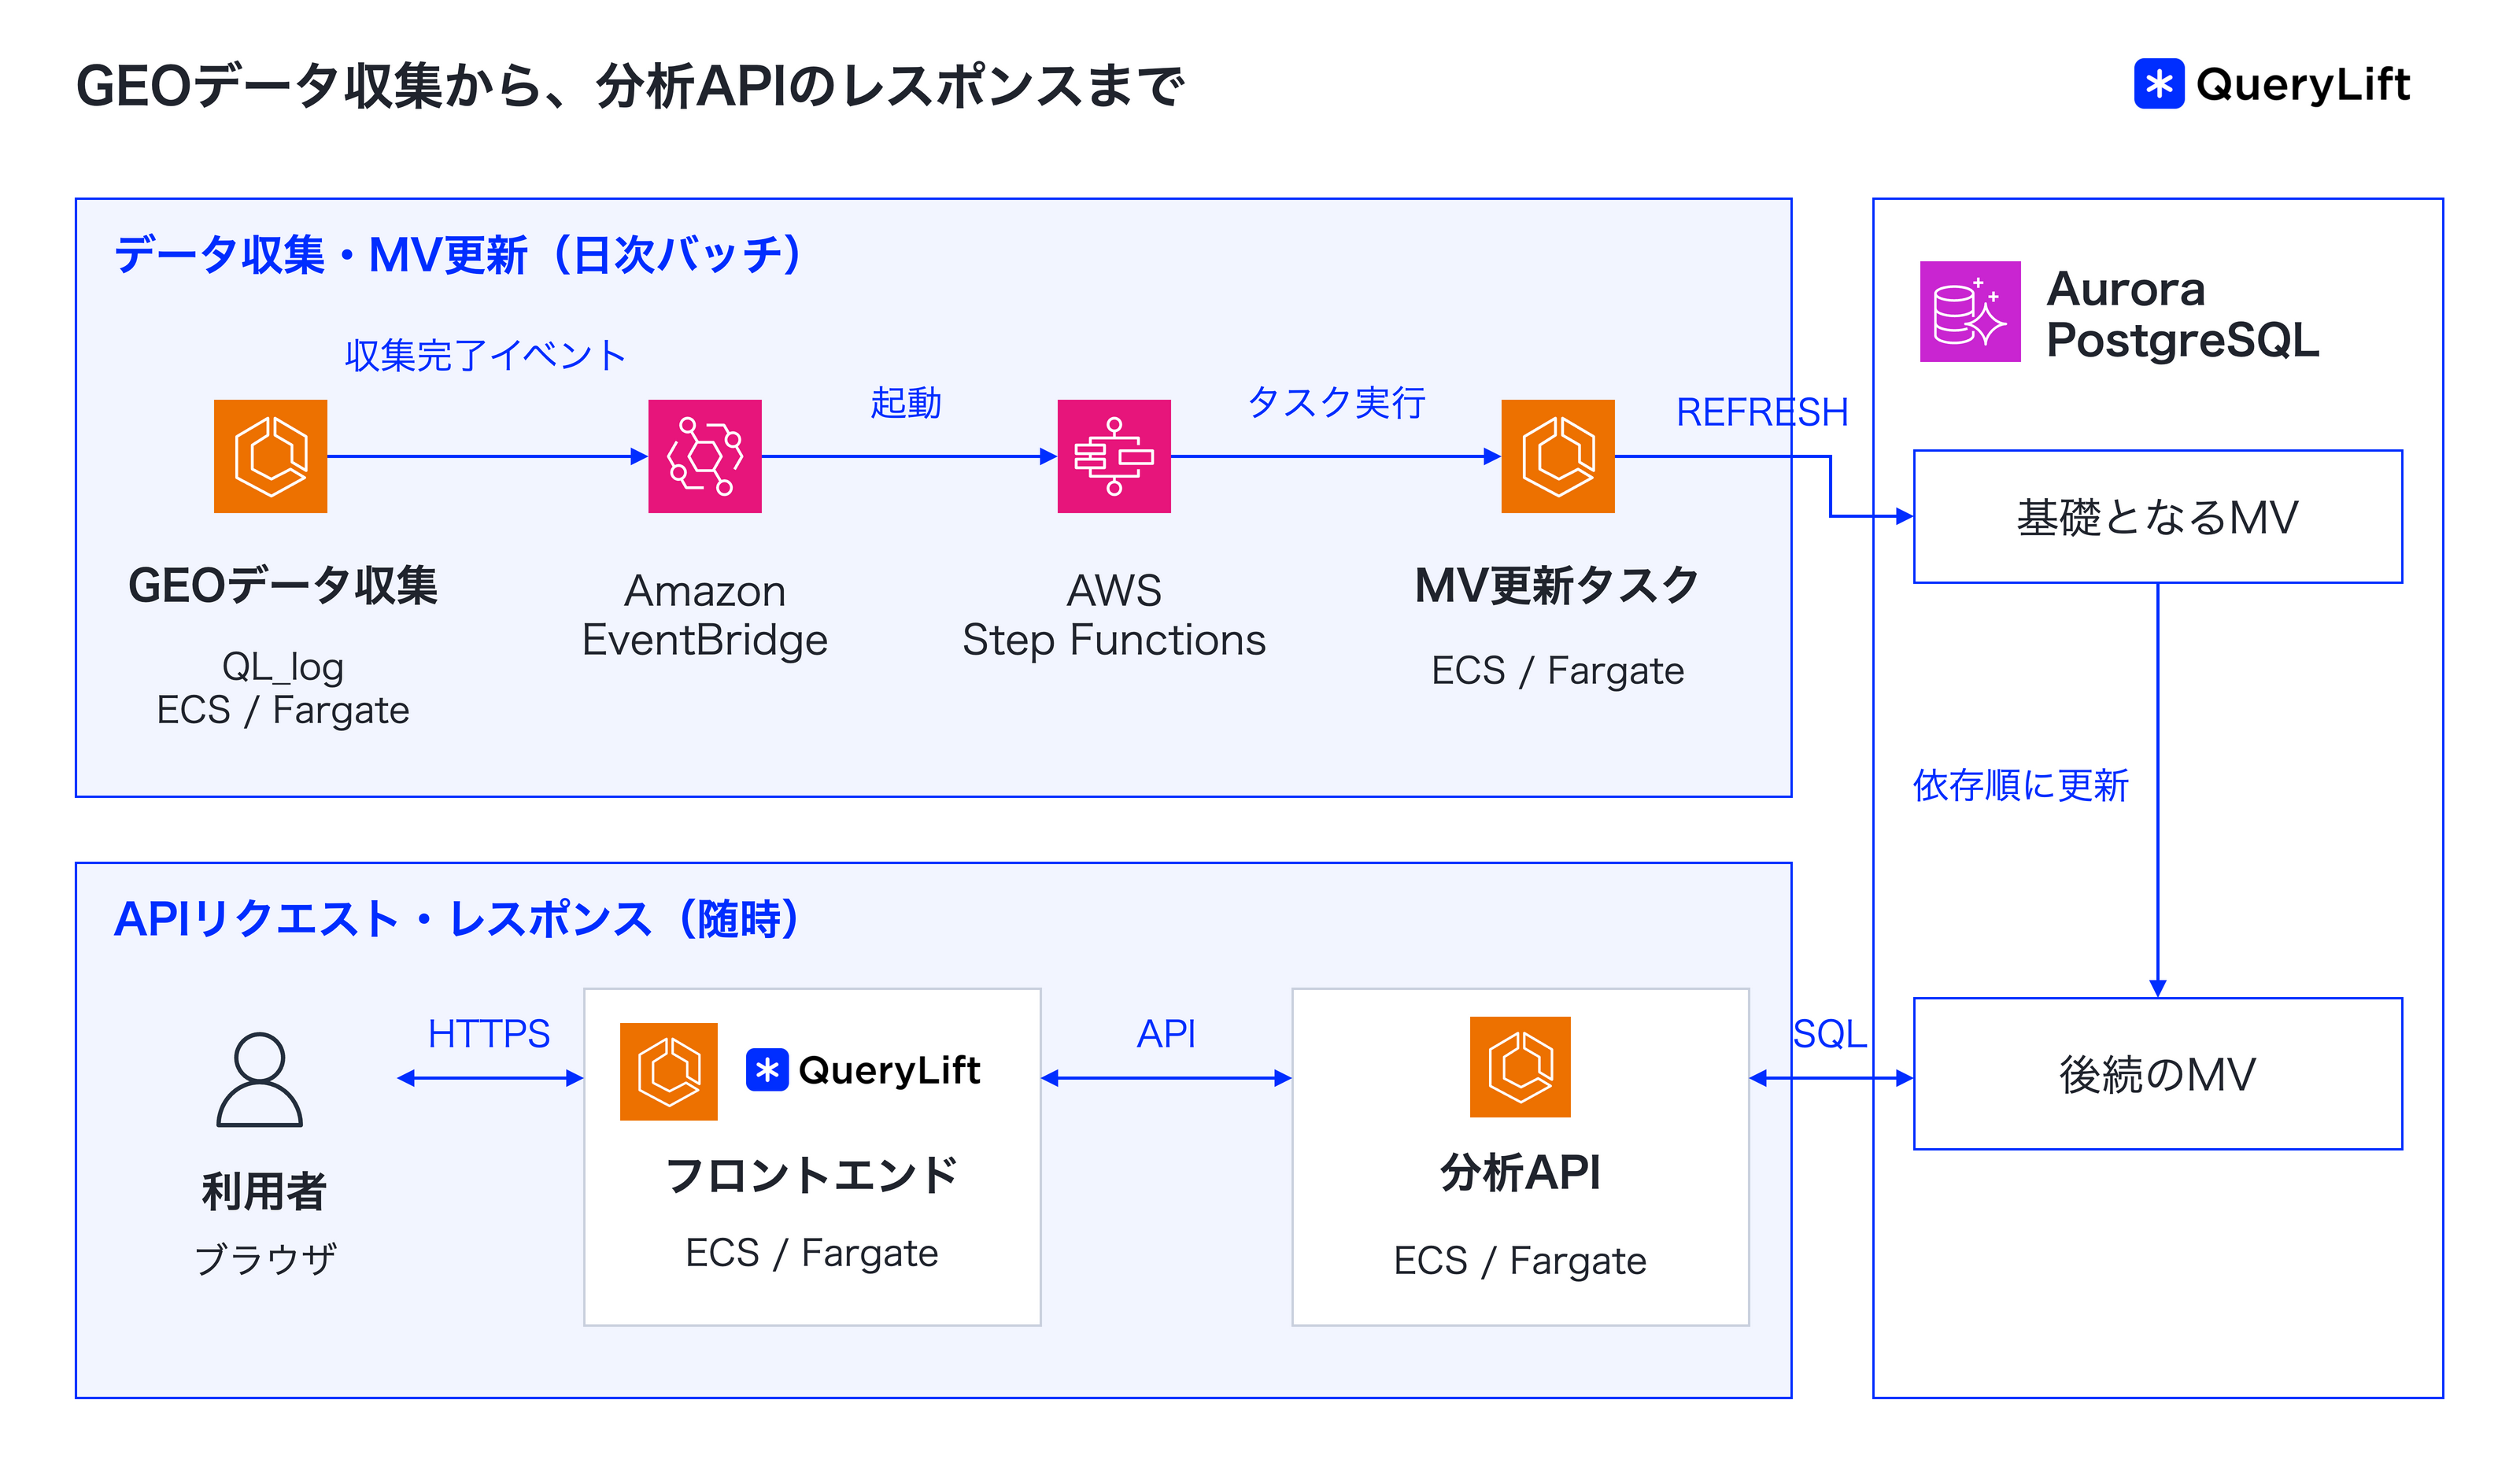
MVの依存関係に沿って更新することで、後続の集計が更新前の中間結果を参照することを避けています。
また、分析データは定期的に更新する一方、当然利用者がMV更新中にアクセスする可能性を考慮する必要があります。そこでMVの更新には、REFRESH MATERIALIZED VIEW CONCURRENTLYを利用しています。
更新タスクでは、対象のMV名を識別子としてクォートし、CONCURRENTLYを指定してSQLを実行します。MVの更新中も分析APIが保存済みの集計結果を参照できるようにし、更新によって読み取りがブロックされることを避けています。
3. 分析条件の変更に対応する過去データの再計算
保存済み回答から、変更後の条件で指標を再計算する
QueryLiftでのGEO分析では、比較する競合企業を追加したり、ブランド名の表記揺れを登録したりすることができます。その際、設定変更後の回答だけでなく、それまでに収集した過去の回答データでも、対象ブランドがどの程度登場していたかを確認したくなります。
このため、回答本文とその分析結果を分けて保持し、現在の競合や表記揺れの設定で指標を再計算できる構成にしています。再計算では収集済みの回答本文は変更せず、同じ観測データに新しい分析条件を適用します。
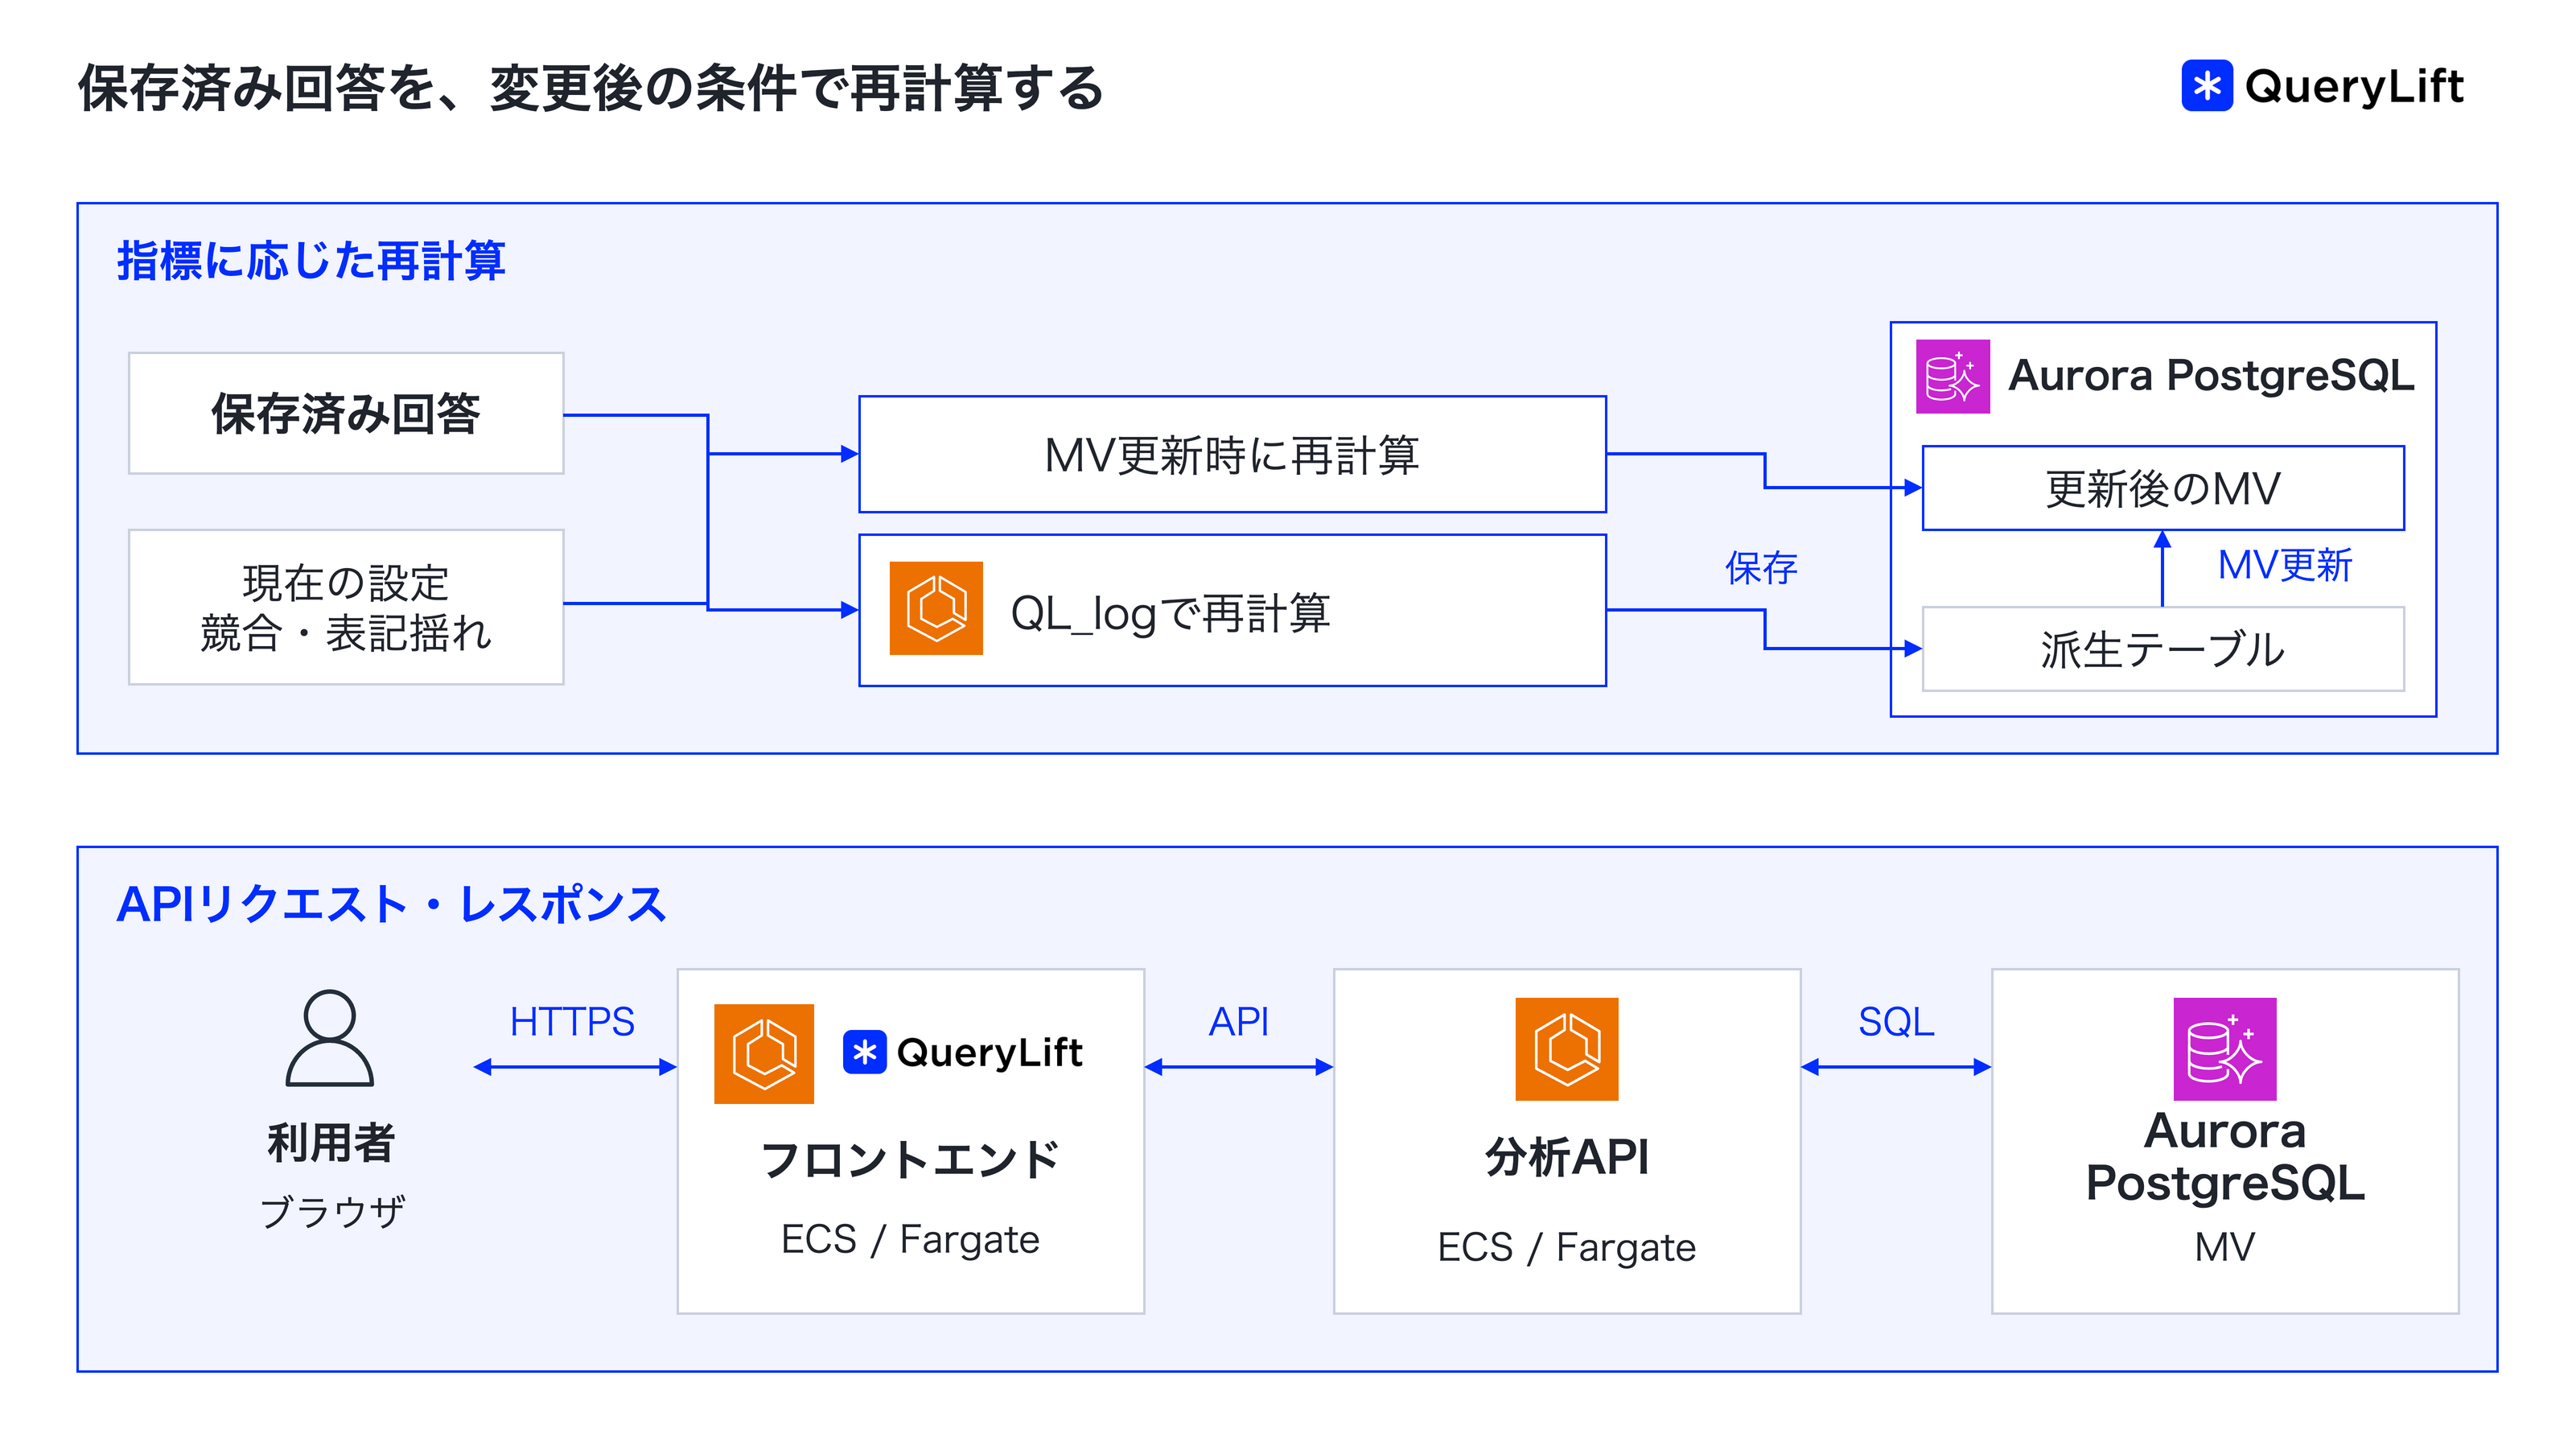
指標によって、再計算の経路は異なります。現在の競合設定や表記揺れを参照するMVは、更新時に保存済み回答から再計算します。一方、言及順位などのテーブルに保持する派生データは、GEOデータ収集バッチ(QL_log)のワーカーで再計算して更新します。
再計算は受付APIでジョブとして登録し、ワーカーが非同期に実行します。受付可能な期間や重複ジョブを確認し、処理の完了と、MV更新によるAPIレスポンスへの反映は別の段階として扱います。
再計算できる期間や範囲には機能ごとの制約がありますが、保存済み回答を活用することで、あとから設定を更新しても、過去データも更新されてGEOを行うことができます。
4. 分析数値の正確性を検証するゴールデンテスト
APIの正常動作だけでなく、集計結果の正しさを検証する
弊社ではユーザー影響のある本番環境エラーは、slackに通知してリアルタイムでパッチ対応を行なっております。しかし、GEOデータのメトリクスでは、APIレスポンスが正常でも、数値の意味が変わってしまう場合があります。例えば、モデルやタグで対象を絞った際に、分子だけが絞られ、分母が全体のまま残ると、返される率は意図した指標ではなくなります。
例えば、ある条件に合う40回答のうち10回答で言及があれば、言及率は25%です。ところが、条件の絞り込みロジックに問題があり分母が100回答となってしまうと、言及率が10%と表示されてしまいます。どちらも正常レスポンスとして返せますが、エンドユーザーに誤ったデータを提供してしまうことになります。
こうした変化を検出するため、QueryLiftでは通常のテストに加え、分析APIの結果を検証するゴールデンテストを実装しています。
固定データでAPIレスポンスを期待値と比較する
テストに使う固定データはGitHub Releaseで管理し、期待結果はリポジトリ内にJSON形式で保存しています。固定データを専用のPostgreSQLに復元し、コード変更後の結果を期待結果と比較します。分析に使う基準時刻も固定することで、実行日の違いによって集計対象期間が変わらないようにしています。
テストでは、APIの処理からデータベースへの問い合わせまでを通して処理を実行し、そのレスポンスを事前に保存済みのJSONと比較します。リクエストIDや実行時のメタ情報など、毎回変わる項目は比較対象から除外します。HTTPのルーティングや認証全体、日次の収集から更新までを通すE2Eテストとは役割を分けています。
単独のフィルタだけでなく、複数条件をAND条件で指定するような複雑なケースも用意しています。条件の組み合わせによって母集団が変わるデータを使い、分母の絞り込みやAND条件が意図どおりに働くかを検証します。
おわりに
分析基盤では、画面に速く結果を返すこと、条件に沿って数値を計算すること、設定変更後にデータを再計算すること、実装変更時に数値を検証することを、それぞれ設計する必要があります。
QueryLiftではサービスの品質向上のための改善を日々実施しています。分析結果をどう速くレスポンスし、数値の正しさをどう安定的に確かめるか。こうした具体的な設計を積み重ね、GEOの分析・判断に安心して活用いただけるサービスを目指しています。
QueryLiftの事業とAWS基盤の全体像については、AWS Startupブログの記事もご覧ください。