この度、QueryLiftの研究部の望月がACM CIKM2026に参加し、口頭発表を行いました。
学会概要
ACM CIKM(Conference on Information and Knowledge Management)は、情報検索、データマイニング、ナレッジマネジメントの幅広い研究分野を扱う年次の国際会議で、計算機科学の世界的な権威学会であるACM(Association for Computing Machinery)がスポンサードしています。ACM CIKMはGoogle Scholarではh5-index*1が96、COREランク*2ではAと、世界的に高く評価されている国際会議です。
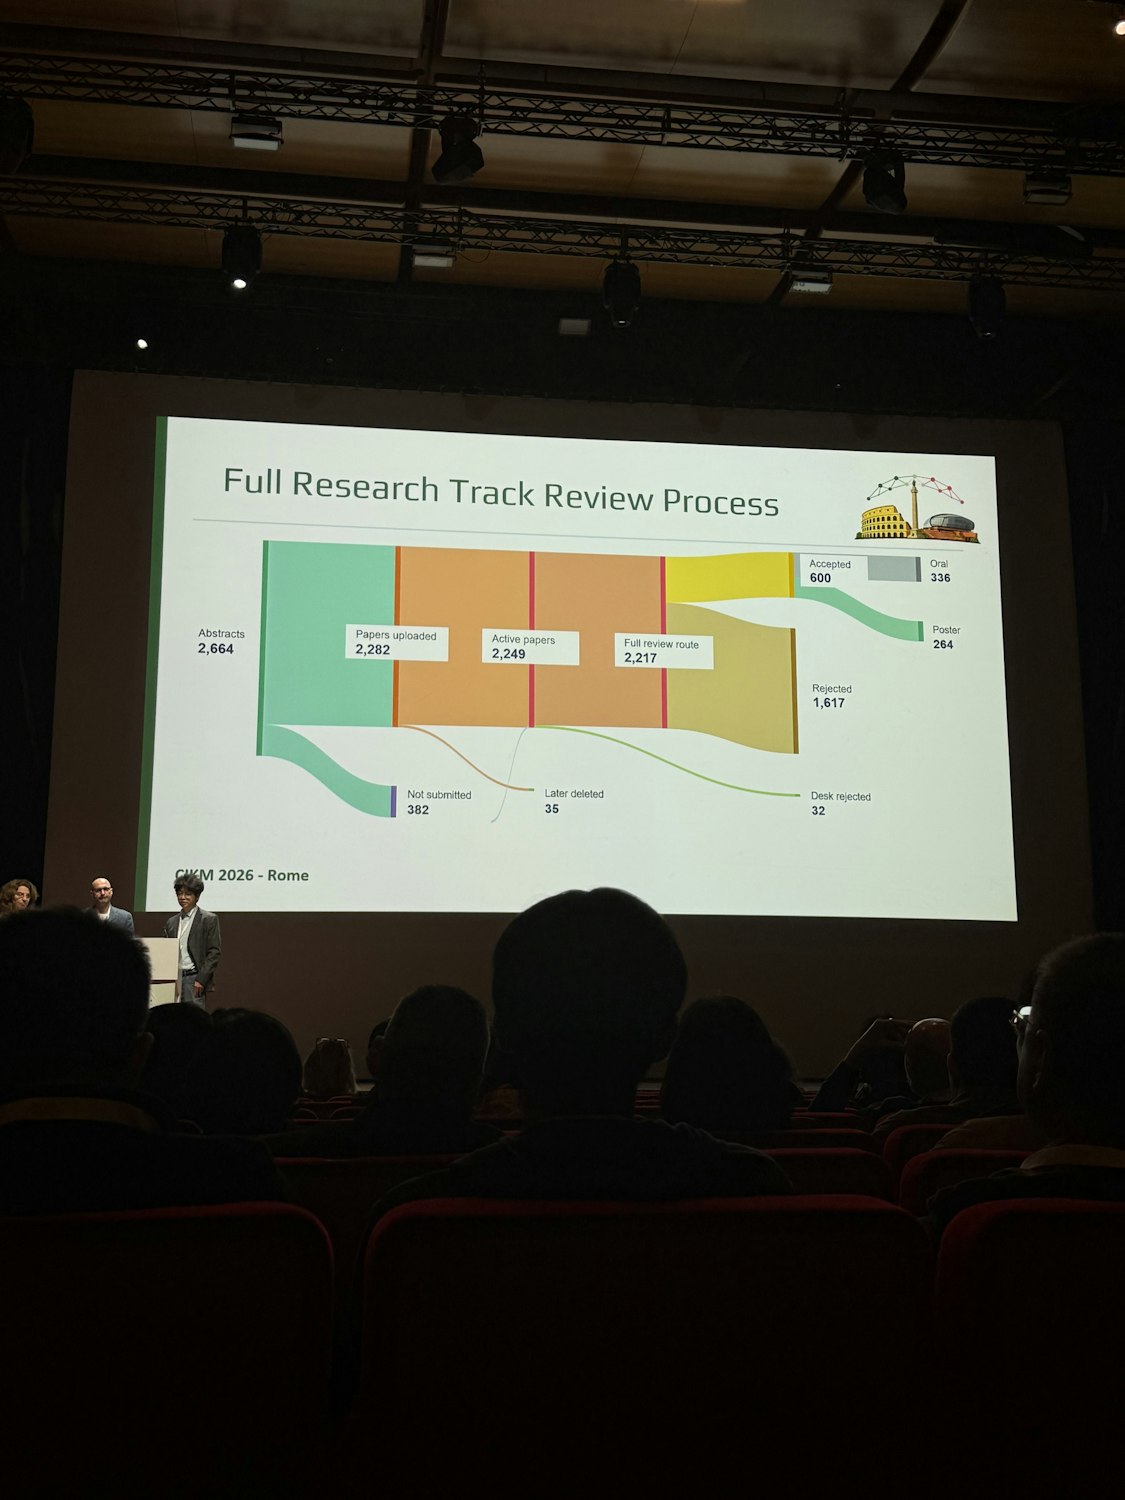
第35回目の開催となるCIKM 2026(公式サイト)は、2026年11月7日から11日にかけてイタリア・ローマで開催されました。7日はTutorialやIndustry Day、8日はWorkshopが開催され、9日から11日が本会議という日程です。Full Research Trackには世界中から2,249件の投稿があり、そのうち600件が採択、336件が口頭(Oral)発表でした。
*1 h5-index:Google Scholarが公開している、論文の引用数にもとづく影響力の指標です。直近5年間に発表された論文のうち、h回以上引用された論文がh本以上あるときの最大のhの値で、数値が大きいほど多く引用されていることを示します。
2 COREランク:CORE(Computing Research and Education Association of Australasia)が公開している、計算機科学分野の国際会議の格付け「International CORE Conference Rankings(ICORE)」です。
学会の様子
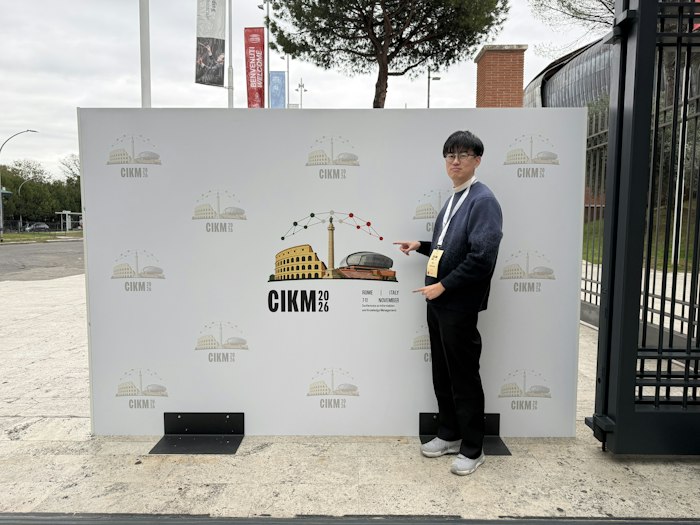
学会はローマ市街地からすぐのAuditorium Parco della Musica(コンサートホール)で行われました。11月9日から11日の本会議は、口頭発表とポスター発表を中心としたプログラムで構成されています。また今年も多数の併設Workshopが開催されました。
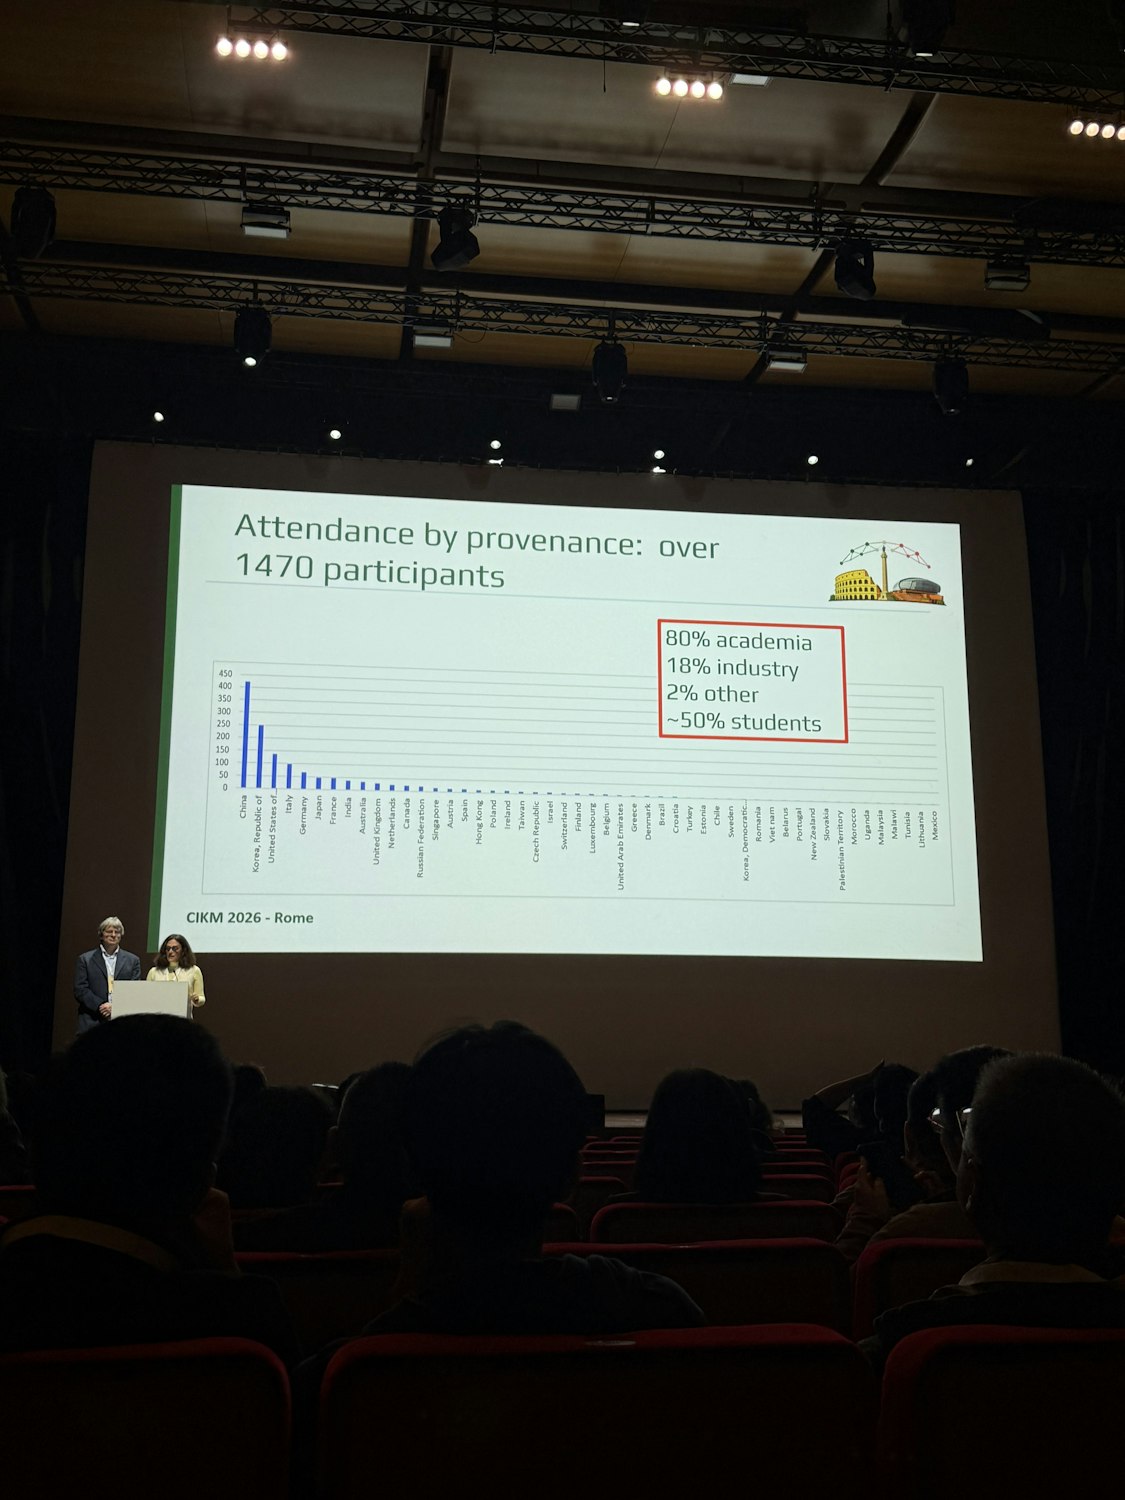
初日のOpening Ceremonyでは、CIKM 2026の投稿・採択状況や参加者の内訳といった統計情報がシェアされました。Full Research Trackには世界中から2,249件の投稿があり、そのうち600件が採択されました。採択論文の内訳は、口頭発表が336件、ポスター発表が264件でした。
参加者は1,470名を超え、国・地域別では中国が最も多く、韓国、米国、イタリア、ドイツと続き、日本は6番目でした。また、所属は80%がアカデミア、18%が産業界でした。
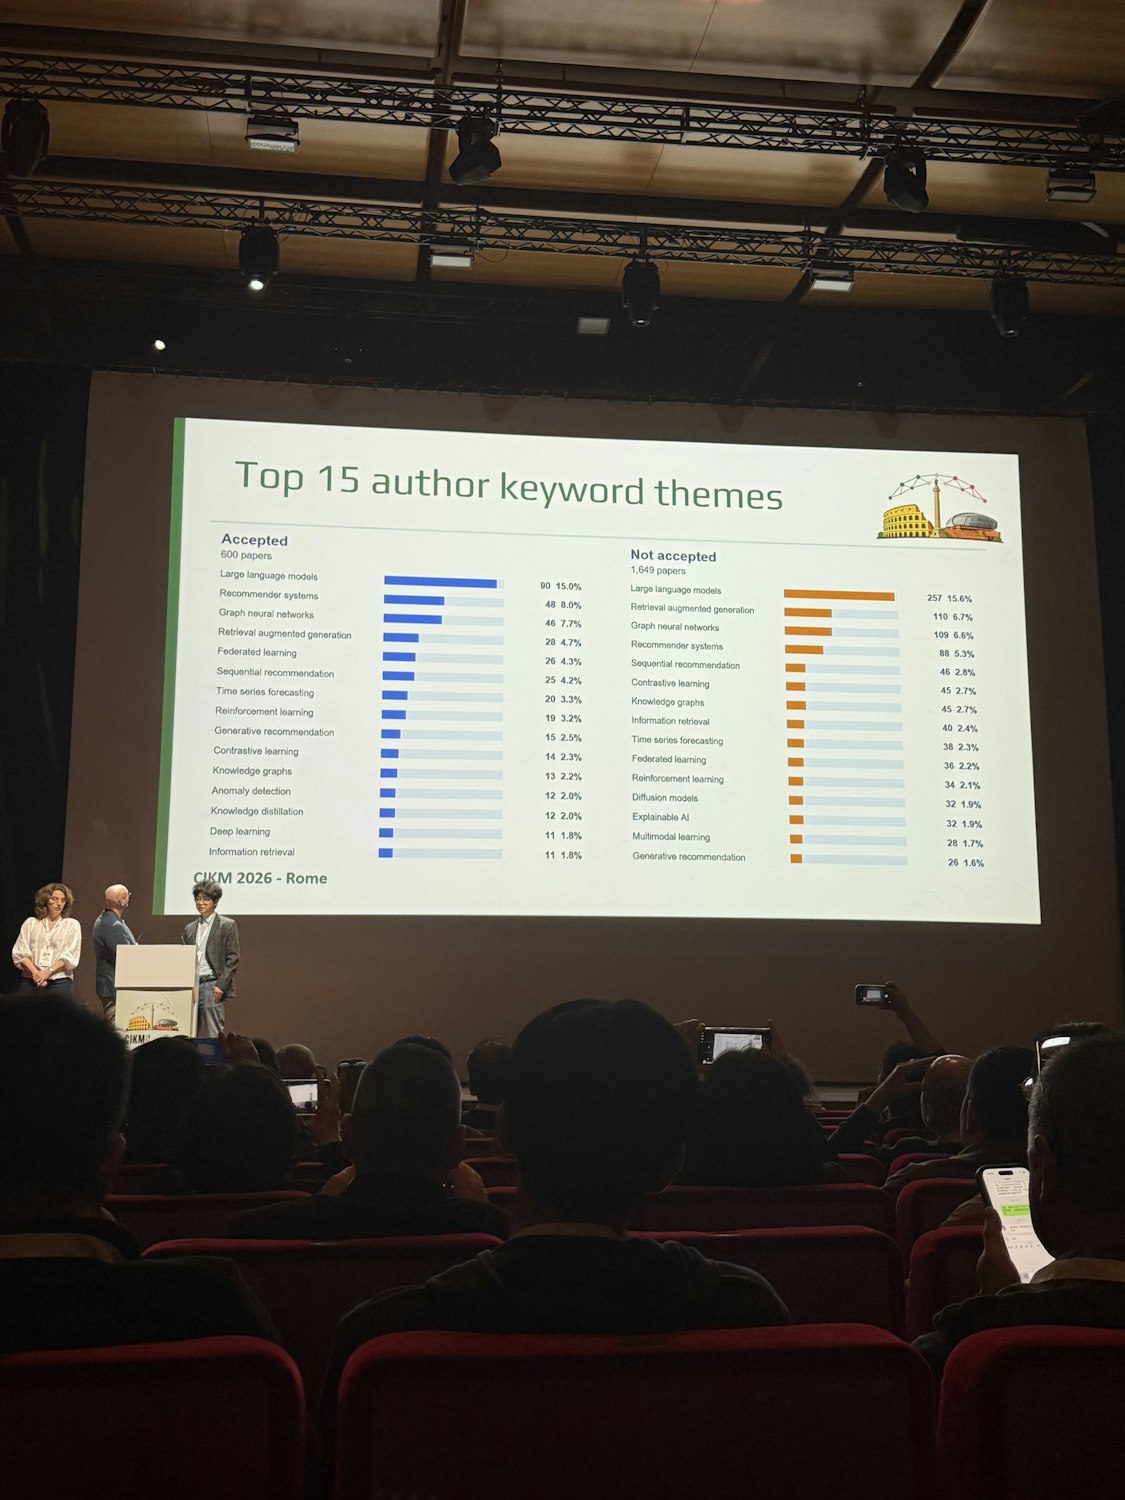
研究のキーワードでは、採択論文でLLMが15.0%で最も多く、推薦システムが8.0%、グラフニューラルネットワークが7.7%、RAGが4.7%と続きました。不採択論文でもLLMが15.6%で最多、RAGが6.7%で2位であり、LLMとRAGに関する投稿が特に多かったことがわかります。QueryLiftが取り組む生成AI検索のセキュリティも、これらと隣り合うテーマです。
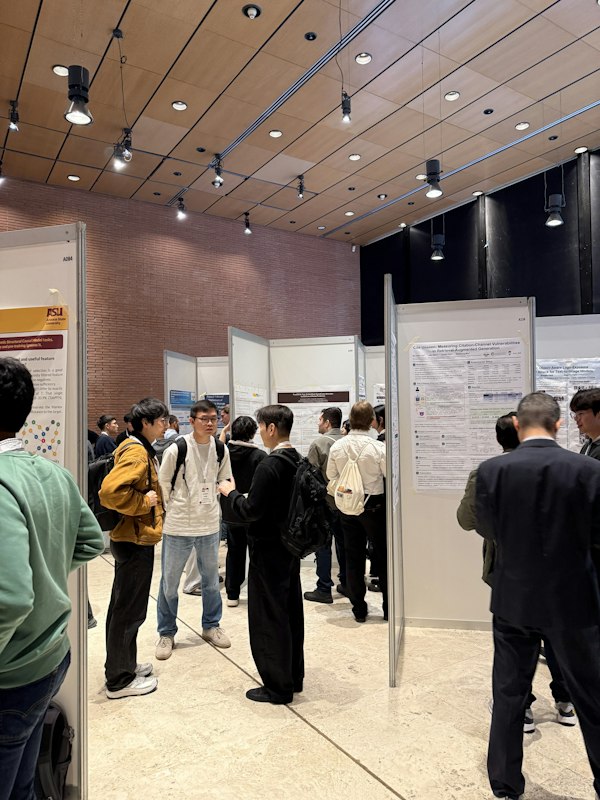
ポスター発表の様子です。Full Research TrackとShort Research Trackの発表が行われました。Full Research Trackだけでも264件がポスター発表で、会場はかなり賑わっていました。
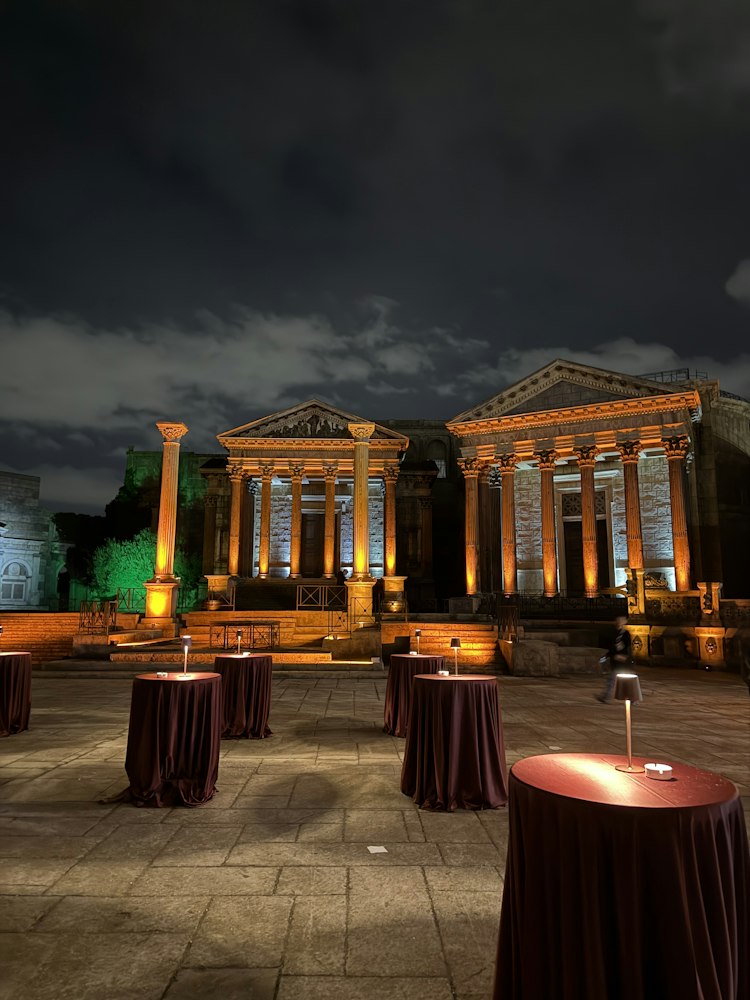
Conference Dinnerは、中日の夜に、映画の都ローマを象徴するCinecittà Studiosで開催されました。古代ローマのフォロ・ロマーノを模した建物群がライトアップされ、Romaを感じる素敵な雰囲気でした。
QueryLiftが発表した研究
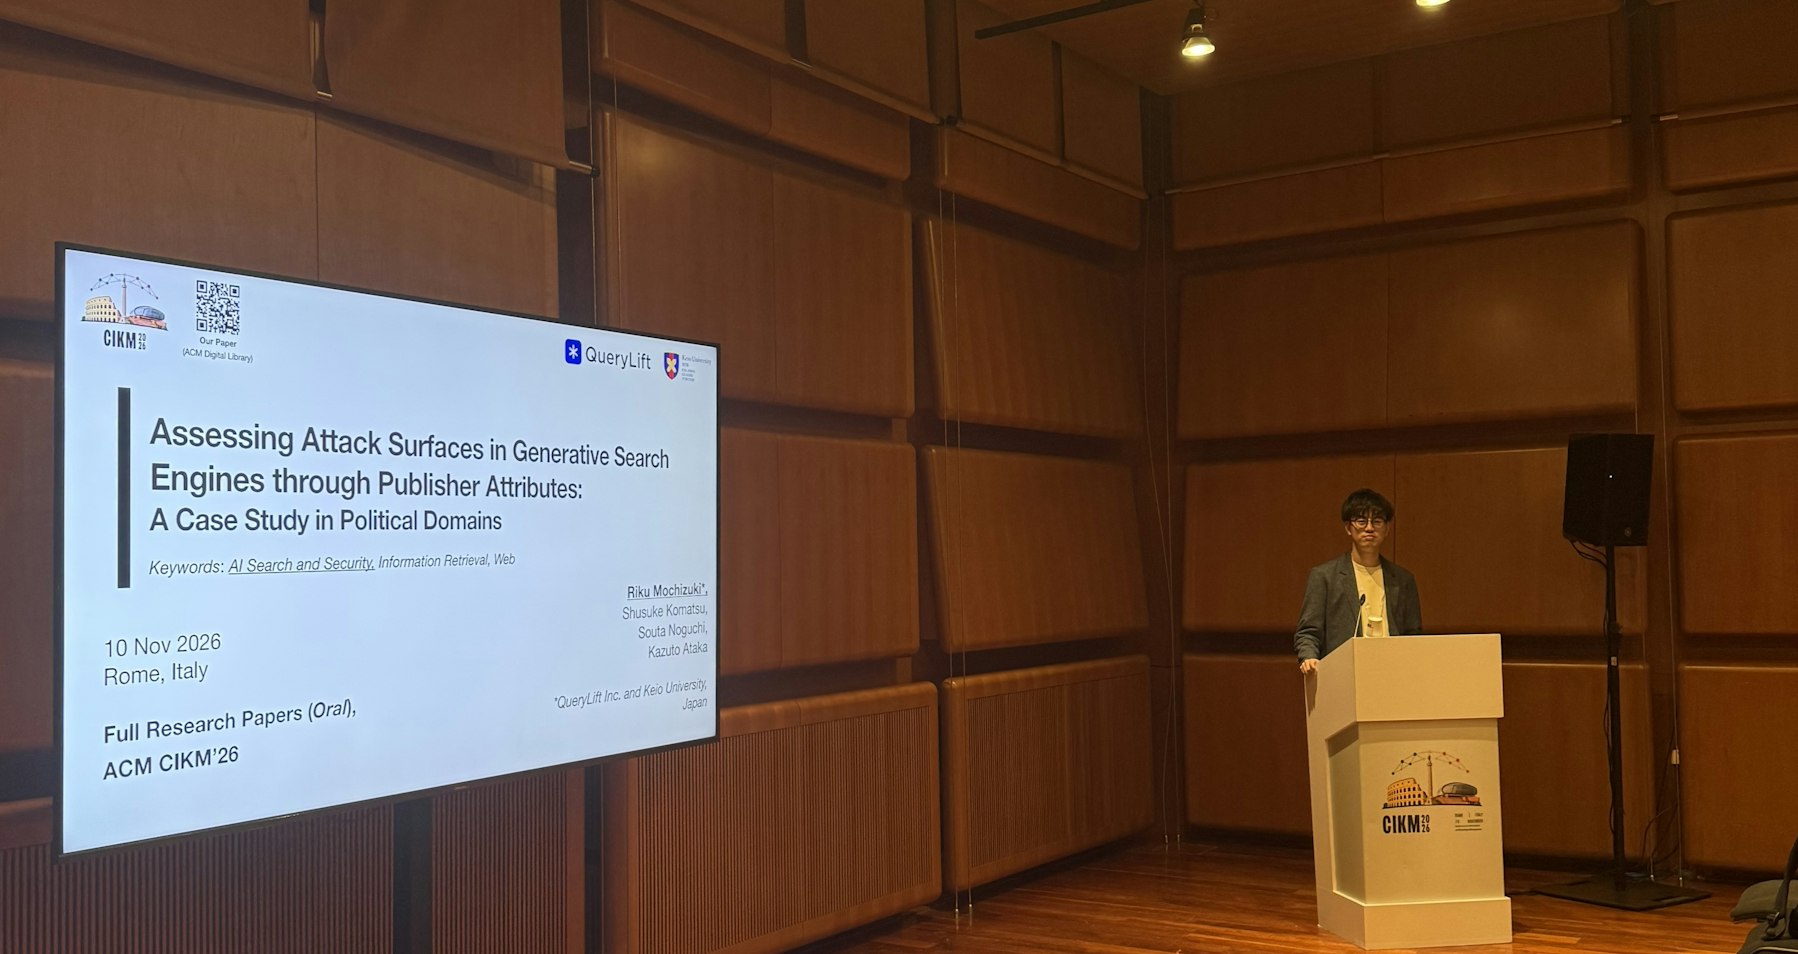
弊社研究部は「Assessing Attack Surfaces in Generative Search Engines through Publisher Attributes: A Case Study in Political Domains」をFull Research Trackで口頭発表しました。
ChatGPTやGoogle AI Overviewなど、Web検索と大規模言語モデルを組み合わせた生成AI検索の普及により、人々が情報へアクセスする方法と得られる情報の質が大きく変化しています。生成AI検索は、AIが自律してWeb上の情報を収集し、情報を引用しながら回答を生成します。生成AI検索は、ユーザーに高度な検索能力をもたらすだけでなく、情報の発信者である企業や組織にとっても、新たなユーザーに情報を届ける機会となります。ただし、この機会は善意の発信者だけに開かれているわけではありません。
生成AI検索には、悪意ある発信者の情報が回答に入り込みやすい構造的な問題があります。Webは誰でも自由に情報を発信できる場である一方、生成AI検索は発信者が誰であるかを十分に考慮するとは限りません。そのため従来の検索とは異なり、知名度や実績がなくとも、「生成AI検索に引用されやすい形」で情報をWeb上に置くだけで、回答に影響を与えられる余地があります。さらに意図的に歪められた情報が回答に引用されると、ユーザーはAIの流暢な文章を通じて本来の意図に気づかぬまま情報を受け取り、意思決定に用いてしまいます。この性質は、組織に対する認識や評価を歪める「認知攻撃」の効果を最大化させ、長年かけてブランドを築いてきた組織にとって深刻な脅威となります。そこでQueryLiftは、認知攻撃からブランドや組織の信頼を守る「防御の視点」を重視しています。
この問題意識のもと、QueryLiftは、どのような情報源が生成AIの回答に取り込まれ、情報操作の入り口となり得るのかを評価する基盤を世界で初めて設計・開発しました。中核となるのは、回答に引用された情報源について「攻撃者がその情報源に内容を掲載・挿入することが、どの程度容易か」を捉える新しい評価指標「コンテンツ挿入障壁(content-injection barrier)」です。
本研究では、認知攻撃が社会の意思決定に多大な影響を及ぼす政治分野にこの評価基盤を適用し、認知攻撃のリスクを洗い出しました。日本と米国の政党に関する質問に対して主要な3つの生成AI検索モデルが生成した計3,861件の回答を分析・評価した結果、(1) 攻撃面の広さはモデルによって大きく異なること、(2) その違いは、引用の選び方よりも前段のウェブ検索の時点で生じていること、(3) 与党に関する質問は野党に比べて障壁の低い情報源に依存しやすいこと、(4) ユーザーの政治的立場や知識量は引用傾向にほとんど影響しないこと、がわかりました。
発表したスライドはこちらからご覧いただけます。
今後の取り組み
ローマで開催されたCIKM 2026では、世界中の研究者が集まる場で研究成果を発表し、議論する貴重な機会を得ることができました。QueryLiftは、これからも研究開発を通じて、認知攻撃から組織やブランドの信頼を守る「防御の視点」を追求してまいります。