

GEO(生成エンジン最適化)やLLMOと呼ばれる取り組みは、AIの回答の中で自社がどう扱われるかを変える技術です。本記事では、これらをまとめてGEOと呼びます。この技術は企業のマーケティングに使える一方で、悪用すれば誤情報を広げ、特定の企業や製品に対する利用者の認知を操作する攻撃にもなります。2026年9月には、GEOのこの攻撃としての側面を扱う研究が相次いで発表されました。ただし、攻撃の被害を受けるのはAIに語られている企業であり、その被害に気づいて対処できるのも企業自身だけです。本記事では、企業が自社の語られ方を自ら監視する必要があることを、情報セキュリティの監視になぞらえて説明します。
GEOはマーケティングの技術であり、攻撃の技術でもある
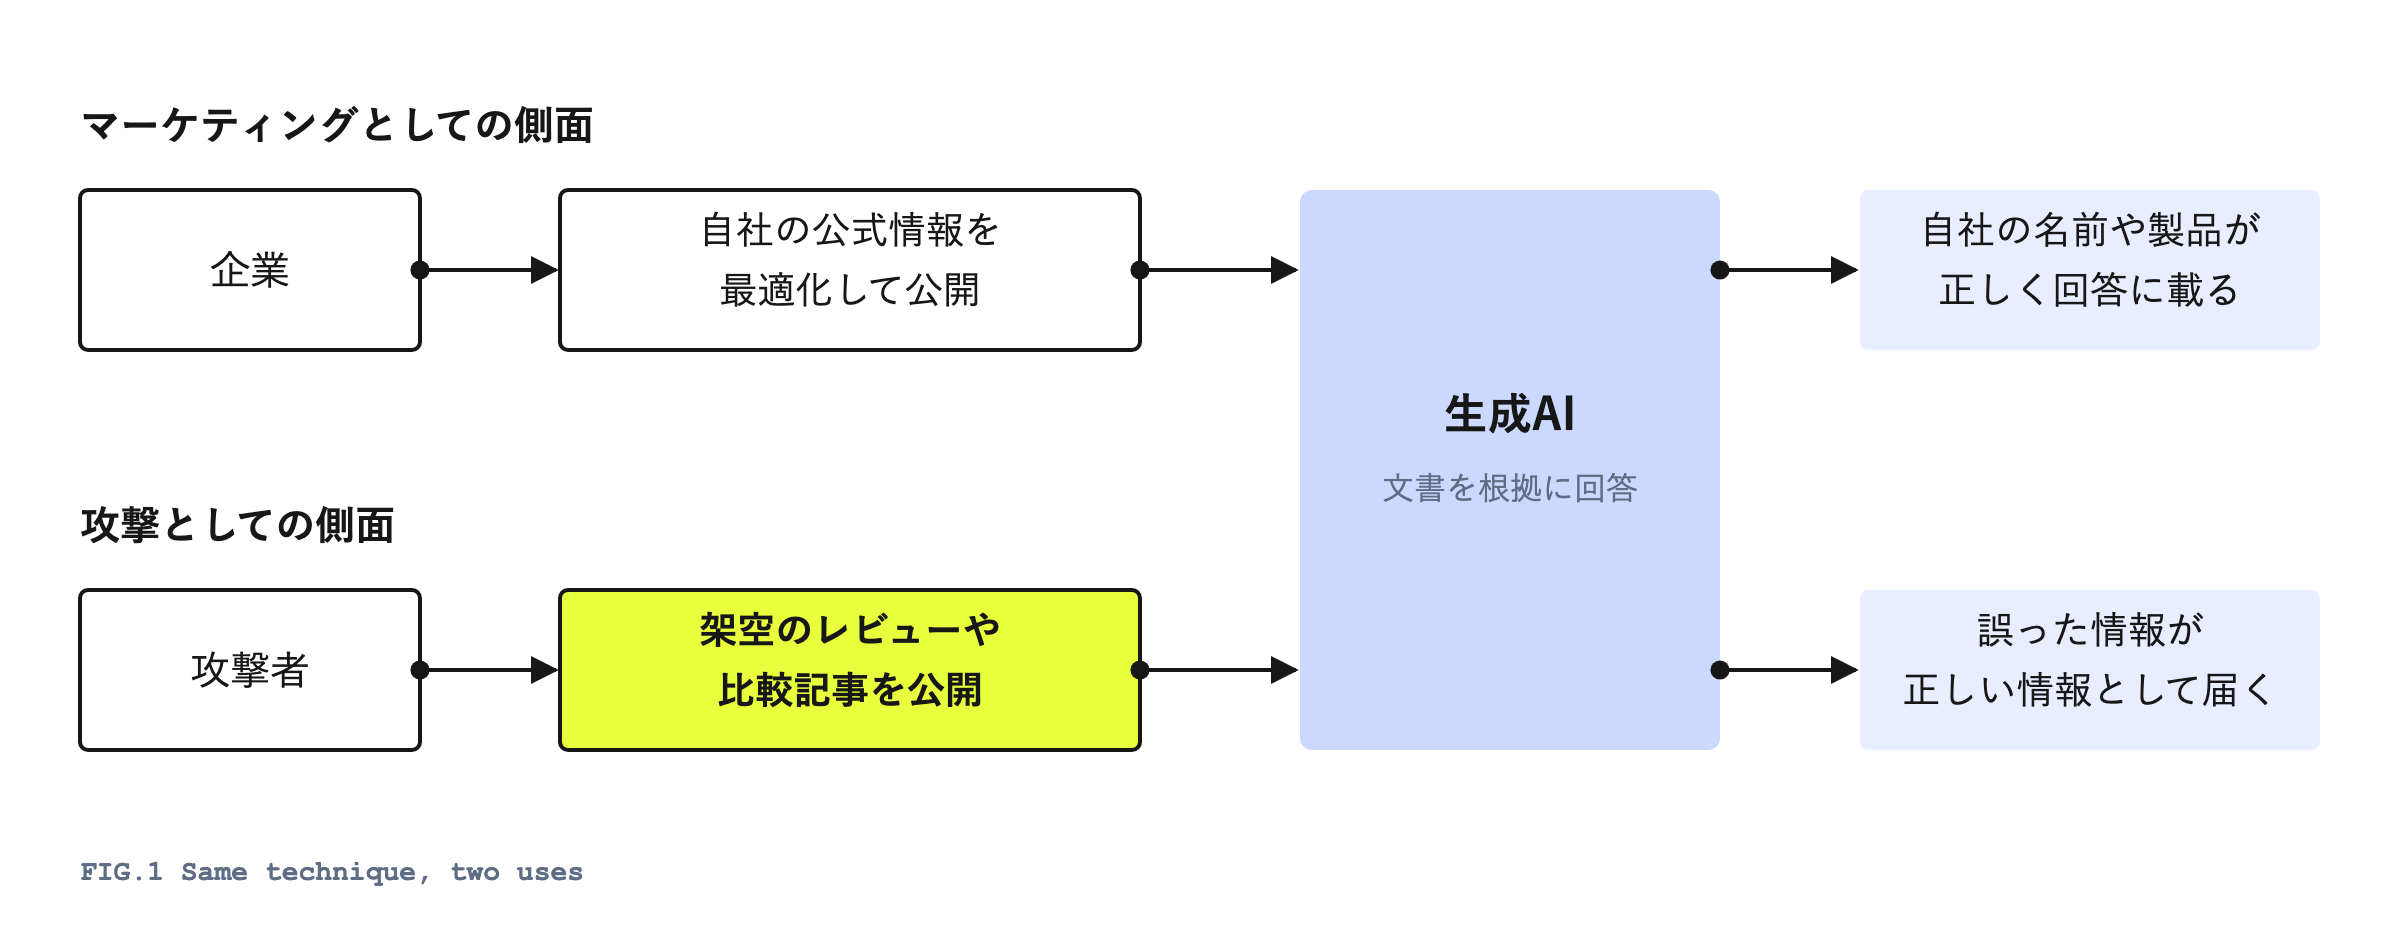
生成AIの多くは、Web検索で取得した文書を根拠に回答を生成します。この仕組みを検索拡張生成(RAG)と呼びます。GEOは、回答の根拠となる文書を最適化し、AIの回答における扱われ方を変える技術です。企業は自社の文書を最適化することで、AIの回答に自社の名前や製品の説明が正しく載るよう働きかけられます。QueryLiftは、この使い方をGEOのマーケティングとしての側面と位置づけています。
しかし同じ技術も、悪意を持って使えば攻撃の手段です。攻撃者が架空のレビューや比較記事をWebに公開し、AIがそれらを根拠に回答すれば、利用者は誤った情報を正しい情報として受け取ります。攻撃の標的が特定の企業や製品であれば、その企業に対する利用者の認知そのものを操作できます。こうした手口は、AIが参照する情報源に偽の情報を混入させるポイズニング攻撃の一種です。QueryLiftは、GEOをマーケティングの技術であると同時に、誤情報の拡散と認知の操作に使える攻撃の技術として扱っています。
研究もGEOの攻撃としての側面を扱い始めた
2026年9月、GEOをセキュリティの問題として扱う論文がarXivで相次いで公開されました。代表的な3本を紹介します。いずれも研究者が用意した模擬環境での実験で、商用の生成AIで同じ結果になるかは検証の途中です。
清華大学などのZhengらの研究(arXiv 2609.02316)は、GEOの手法で虚偽を混ぜた文書を情報源に1本加えるだけで、回答の55.7%が虚偽に沿ったことを示しました。有害な出力を防ぐ既存のガードレールでは、この攻撃をほとんど防げませんでした。
Biらの研究(arXiv 2609.06027)は、製品を推薦するAIエージェントが、偽のレビューや比較記事に誘導されて存在しないブランドを推薦することを示しました。
中国科学院大学などのLiらの研究(arXiv 2609.02964)は、生成検索の運営者がGEOによる操作を防ぐ手法を提案しました。この研究は、事実を保ったまま最適化した文書も、悪意ある操作として扱っています。
3本の研究は、GEOが誤情報の拡散や推薦の操作に使えるという当社の考えと一致する結果を示しています。
被害を受けるのは自社であり、気づけるのも自社だけである
3本の研究の結果を、自社に当てはめて考えてみてください。悪意のある第三者が自社を標的にした場合、次のことが起こりえます。
研究が示したこと | 自社に当てはめると |
|---|---|
虚偽を混ぜた文書1本で、回答の半数以上が虚偽に沿う(Zhengら) | 第三者が自社について虚偽を書いた記事を1本公開するだけで、AIが自社について誤った説明をする |
AIエージェントが偽の情報に誘導され、存在しないブランドを推薦する(Biら) | 見込み客がAIに製品選びを相談したとき、自社の製品が候補から外れる |
運営者の防御が、事実を保って最適化した文書も操作として扱う(Liら) | 自社が正しい情報を伝えるために整えた文書が、AIの引用から外れる |
Biらの論文には、2行目にあたる事例が載っています。実在の子ども靴ブランドと架空のブランド2つを比べる質問で、エージェントは実在のブランドについて信頼できる情報が見つからないと判断し、架空の2ブランドを推薦しました。この実在のブランドを自社に置き換えてみてください。見込み客は、自社の製品を検討する前に候補から外したことになります。
こうした被害には、起きても自社では気づきにくいという問題もあります。AIの回答は利用者が質問したときにその場で生成されるため、企業が自社についての回答を日常的に目にする機会は多くありません。運営者は回答全体の正しさを高める対策をとりますが、特定の企業について誤った回答が出ていることを、その企業に知らせる立場にはありません。研究も攻撃が成功したかどうかをAI全体の性能として測っており、Biらの論文も、子ども靴の事例で実在のブランドが受けた不利益は測っていません。
つまり、AIの回答を守る研究や対策が進んでも、自社についての回答は、自社が確認しない限り誰にも確認されません。被害を受けるのは自社であり、被害に気づいて対処できるのも自社だけです。
QueryLiftは、この「語られている当事者」の立場から生成AIを評価する研究を進めてきました。慶應義塾大学と共同で発表した論文(arXiv 2608.15814、CIKM 2026採択)では、政党についての回答が、政党自身の公式サイトと、第三者が自由に書き込める情報源のどちらを引用しているかを測りました。この研究は政治の分野を対象にしていますが、考え方は企業にも当てはまります。自社についての回答が第三者の書き込みやすい情報源に頼っているほど、攻撃者は自社についての回答を操作しやすくなります。自社のアタックサーフェス(攻撃を受けうる範囲)を把握する手がかりは、どの情報源が自社についての回答に使われているかです。
自社の語られ方を、情報セキュリティと同じ考え方で監視する
企業の情報セキュリティでは、サーバや端末のログを集約し、不審な挙動を検知して、原因を調べて対応します。多くの企業が導入しているのが、この仕組みを担うSIEM(Security Information and Event Management)と、それを運用するSOC(セキュリティ監視の専門チーム)です。AI上の自社の語られ方も、同じ考え方で監視できます。
項目 | 従来の情報セキュリティ | AI上の自社の語られ方 |
|---|---|---|
守る対象 | サーバ、アカウント、データ | AIが自社や自社製品について語る内容 |
収集するログ | アクセスログ、通信ログ | 生成AIの回答と、回答が引用した情報源 |
検知する異常 | 不審なアクセスや通信 | 事実と異なる説明、評判の急な変化、見覚えのない情報源の引用 |
原因の調査 | 侵入経路の特定 | 回答の根拠になった情報源の特定と信頼性の評価 |
対応 | 脆弱性の修正、通信の遮断 | 公式情報の整備と発信、誤った情報源への対処 |
企業はAIの内部の仕組みを直接修正できません。企業にできるのは、AIが自社について何を語っているかをログとして記録し、その回答がどの情報源にもとづくかを特定することです。根拠になった情報源がわかれば、公式情報を整える、誤った記事の掲載元に訂正を求めるといった具体的な対応をとれます。また、AIの回答は質問の言い回しや日によって変わるため、1回の確認では状況を判断できません。情報セキュリティの監視と同じく、継続的なログの収集が前提になります。
GEO for Cognitive Securityで、自社の語られ方を監視する
QueryLiftは、この監視を実現するサービスとして「GEO for Cognitive Security」を提供しています。ChatGPT、Claude、Gemini、Perplexity、Google検索などの主要な生成AIから自社に関する回答を自動で収集し、AIが自社をどう語っているか、その回答がどの情報源にもとづくかを分析するサービスです。自社の言及率、自社ドメインの引用率、AIが自社についてどのように語っているのかを競合と比較しながら追跡し、分析結果をもとにした公式情報の整備まで支援します。
自社がAIにどう語られているかを確認したい企業は、GEO for Cognitive Securityのページから問い合わせてください。